DeepSeek zveřejnil DeepInfer, inferenční framework pro své modely
Společnost DeepSeek zveřejnila na GitHubu pod licencí Apache 2.0 projekt DeepInfer. Podle popisu jde o výkonný framework pro velkoškálovou inferenci, který pohání produkční služby DeepSeeku. Open source verze ale nabízí jen offline inferenci s klíčovými funkcemi potřebnými pro nasazení ve velkém. Podporovaným modelem je zatím DeepSeek-V4.1-Flash, výchozí checkpoint se stahuje z Hugging Face.
Co framework umí
- optimalizované kernely, runtime modelu a samplování, mj. na bázi knihoven FlashMLA, DeepGEMM, DeepEP a vlastních TileLang kernelů
- paralelizaci Attention DP / balanced CP a MoE EP + EPLB
- DSpark a verifikaci řízenou odhadem spolehlivosti (confidence-scheduled verification), která zrychluje dekódování pomocí návrhových tokenů
- SWA bounded replay, tedy omezení práce při prefillu na ohraničený suffix
- asynchronní plánování s téměř nulovou režií
- batch-invariantní inference a deterministické samplování, které dávají stejné výstupy pro stejný vstup (zatím jen na NVIDIA)
- strukturované výstupy omezené regulárním výrazem, JSON schématem nebo gramatikou EBNF
Hardware a požadavky
DeepInfer cílí na GPU NVIDIA generace SM100 a na NPU Huawei Ascend 950. Ke sestavení je potřeba Linux, GCC 13 a novější, Python 3.12 a podle platformy CUDA 13, nebo CANN 9.2. Samotné sestavení je jednoduché: nastaví se proměnná DEEPINFER_ACCELERATOR a spustí se build.sh. Příklad offline inference je v adresáři examples.
Co v release chybí
Pro provoz kompletní inferenční služby si budou muset zájemci doplnit vlastní KV cache systém, oddělení fází VE/Prefill/Decode (většina potřebné funkcionality prý už v enginu je) a vyvažování zátěže mezi datově paralelními replikami pro prefill i decode. Autoři také uvádějí, že framework původně vznikl především nad vLLM a čerpal inspiraci z SGLang a TensorRT-LLM.
Výkon
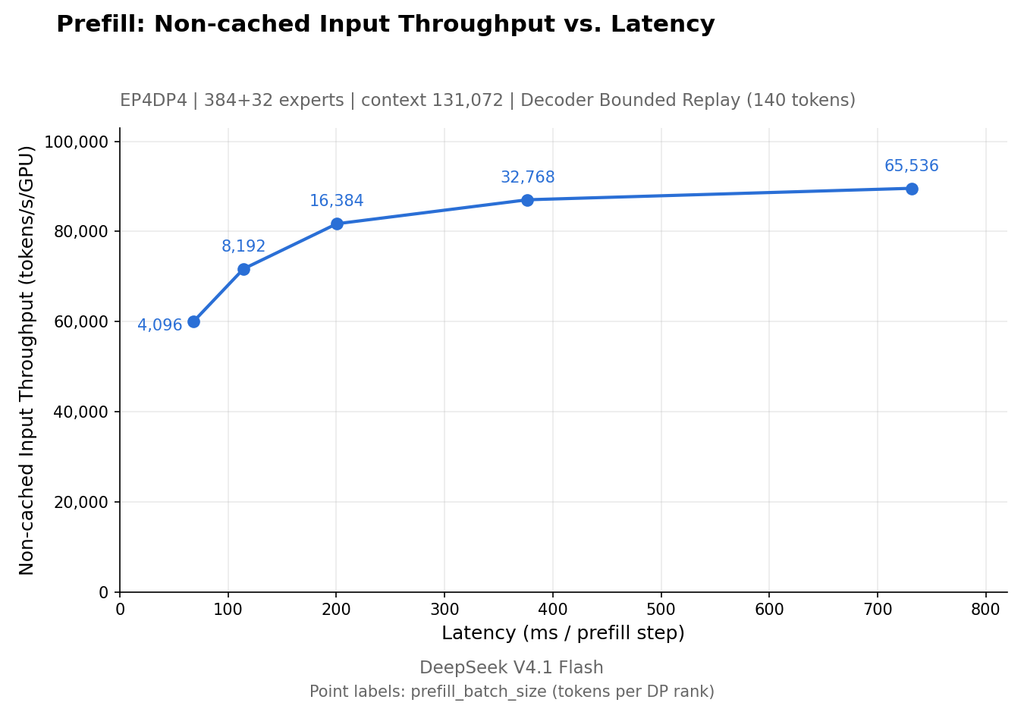
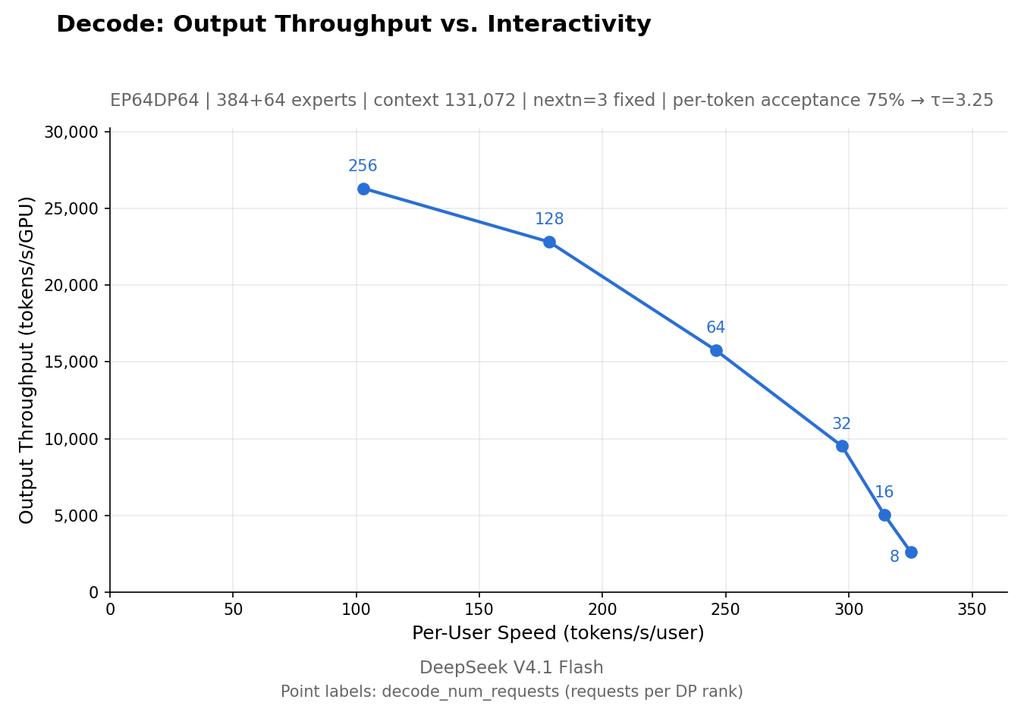
Prefill byl měřen na 4 GPU SM100, decode na 64 GPU, vždy v rámci jedné scale-up domény. Skript pro reprodukci měření je součástí repozitáře.
Adam Heglas
Student se zájmem o IT, programování a kybernetickou bezpečnost. Baví mě se učit novým věcem a posouvat své schopnosti dál. Když zrovna nesedím u kódu, věnuji se fitness a počítačovým hrám.