Vercel zrychlil směrování v CDN. Překvapivě pomohly menší bloky
Vercel zrychlil směrování v CDN tím, že začal načítat víc dat najednou. U velkých webů mu po každém nasazení scházely v cache údaje o mnoha jednotlivých cestách, takže je musel opakovaně dohledávat. U nových bloků metadat Vercel naměřil o 91 % kratší dobu tohoto hledání v 99. percentilu. Cesta k výsledku ale vedla přes nečekané zjištění: příliš velký blok se při vyřizování požadavků nevyplatil.
CDN Vercelu doručuje obsah ze serverů blízkých návštěvníkům. Než odpoví, musí pro požadovanou adresu určit, zda má vrátit soubor, spustit funkci a zda lze odpověď uložit do cache. K tomu používá směrovací metadata: záznamy o tom, která cesta vede ke kterému výstupu webu. Cestou se tu rozumí část adresy za doménou, například /blog/rychlejsi-cache. Cache těchto záznamů je oddělená od cache hotových stránek. Samotná uložená stránka CDN ještě neřekne, zda právě požadovaná adresa vede k jejímu obsahu. Když tuto informaci potřebuje, musí ji najít ve směrovacích metadatech.
U malého projektu se cache směrovacích metadat rychle naplní údaji o navštěvovaných cestách. Rozsáhlý web však může mít stovky tisíc cest a návštěvníci se mezi nimi rozloží. První požadavek na méně navštěvovanou cestu může přijít až dlouho po nasazení nové verze. Jestli její záznam v cache dosud není, musí si ho CDN nejprve opatřit. Tato opakovaná čekání chtěl Vercel zkrátit.
Co přesně hledá CDN
Při sestavení webu vznikne popis výstupů a pravidel, která propojují adresy s obsahem nebo funkcemi. Adresa v požadavku přitom nemusí být totožná s cílovou cestou v tomto popisu. Třeba /blog/rychlejsi-cache může obsloužit společná dynamická trasa /blog/[slug], v níž část v hranatých závorkách zastupuje konkrétní článek. Pravidla mohou směrovač přivést i k více možným cílům. U každého potřebuje zjistit, zda existuje a jak se má obsloužit, než vybere správnou odpověď.
S první otázkou mu pomáhá Bloomův filtr, rychlý předběžný test existence cesty. Dokáže s jistotou vyloučit cesty, které v nasazení nejsou. Možnou shodu už ale potvrdit neumí: může připustit i neexistující cestu. Směrovač proto u zbývajících cest stále potřebuje přesně dohledat metadata.
Původně byla metadata každé cílové cesty samostatným objektem. Směrovač jej načetl a uložil do cache zvlášť. Stahoval tedy jen potřebný záznam, ale načtení jedné cesty nepřipravilo žádnou další. Záznamy starší verze navíc nejsou pro nové nasazení použitelné, takže se metadata jednotlivých cest po každém nasazení musela do cache postupně načíst znovu.
Jedno načtení připraví další cesty
Nový formát sdružuje metadata několika cest do jednoho datového bloku. Když jej směrovač načte kvůli jedné cestě, připraví tím v cache i ostatní cesty v bloku. Nemusí přitom stahovat metadata celého nasazení najednou: velikost každého bloku je omezená.
Starý postup při chybějícím záznamu používal dva síťové požadavky za sebou, HEAD a GET: prvním získal informace o objektu, druhým stáhl obsah metadatového záznamu. Nový postup po kontrole Bloomovým filtrem načte jeden blok a konkrétní cestu v něm vyhledá přímo.
Spojení záznamů do bloku by ale mohlo přidat jinou práci: při každém požadavku procházet a zpracovávat celý soubor. Vercel proto cesty v bloku seřadil. V souboru se střídá řádek s cestou a řádek s jejími metadaty ve formátu JSON; index ukazuje, kde každý záznam začíná. Směrovač v seřazeném indexu při hledání postupně vyřazuje polovinu zbývajících cest. Jako JSON pak zpracuje až metadata nalezené cesty. Metadata ostatních cest zůstávají nerozebraná.
Ukazatele v indexu jsou zapsané textovým kódováním Base64 a mají pevnou délku. Směrovač tak může skočit rovnou na vybraný ukazatel, aniž by přečetl všechny předchozí, a dekódovat jej samostatně. Díky tomu ani hledání uvnitř bloku nevyžaduje zpracování všech jeho metadat.
Informaci o tom, který blok má směrovač pro danou cestu použít, získá už při prvním dohledání metadat nasazení. Výběr bloku tedy nepřidává další síťový dotaz.
U adresy /blog/rychlejsi-cache tak pravidla nejdřív ukážou na cílovou trasu /blog/[slug]. Bloomův filtr ji nevyloučí, směrovač určí příslušný blok a v jeho indexu najde jediný záznam, který potřebuje. Pokud blok předtím v cache chyběl, jeho načtení zároveň přineslo metadata dalších cílových cest. Odpověď se pořád určuje pro jednu adresu; společně se přenášejí data užitečná pro příští požadavky.
Teď však záleží na tom, kolik cest do bloku vložit. Větší blok připraví víc cest jedním načtením, ale při každém přenosu musí putovat víc dat. Právě tento kompromis Vercel ověřoval na skutečných požadavcích.
Proč nevyhrál největší blok
Vercel nejdřív zkusil bloky o několika megabajtech. Očekával, že se metadata většiny nasazení vejdou do jediného bloku. Každý směrovací proces, tedy jedna běžící instance programu, má vlastní malou cache nedávno použitých bloků. Kdyby požadavky často připadaly stejnému procesu, velký blok by se k němu přenesl jednou a při dalších požadavcích už by čekal v jeho paměti.
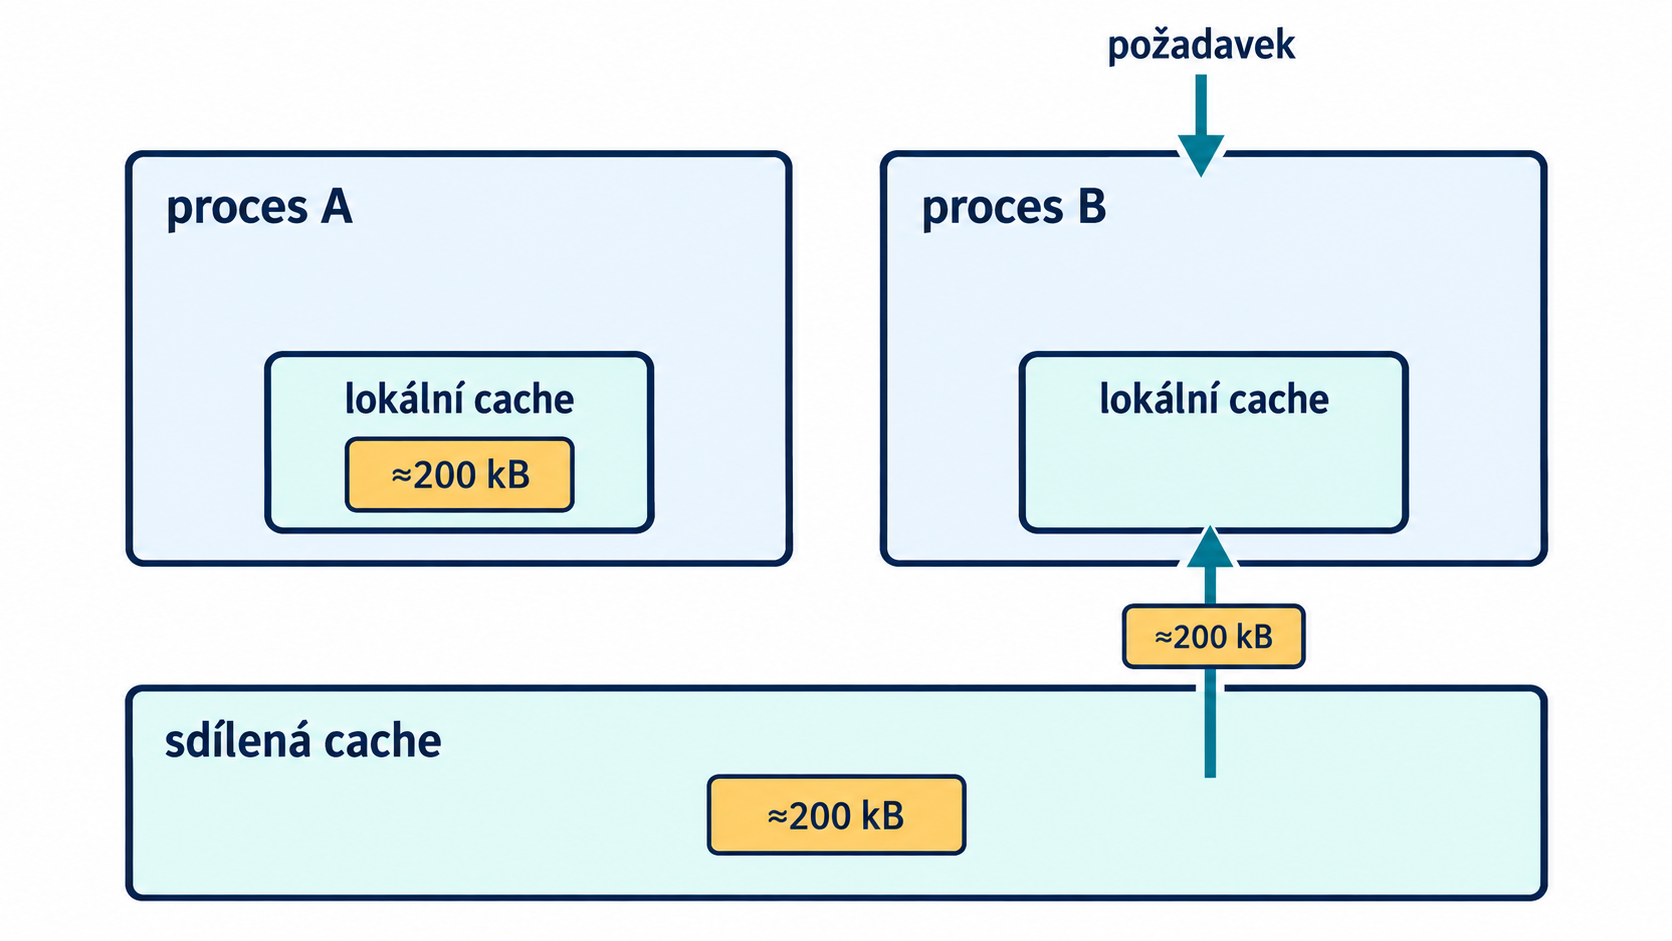
Požadavky se však rozdělují mezi mnoho procesů. Správný blok proto v jejich malých lokálních cache často chyběl. Větší regionální cache, sdílená mezi procesy v dané oblasti, jej sice obvykle měla, ale musela blok přenést do procesu, který požadavek právě vyřizoval. U několika megabajtů byl citelný i tento přenos mezi sdílenou cache a procesem.
Dva po sobě jdoucí požadavky ze stejné oblasti mohou vyřizovat různé procesy. Blok v paměti prvního se tím automaticky nedostane do paměti druhého. Pokud je v regionální cache, druhý proces si jej odtud musí převzít. Velký blok tedy může být ve sdílené cache připravený, a přesto každý další přenos stojí čas.
Zmenšení bloků pomáhalo, dokud nepřevážila opačná potíž. Příliš malé bloky znamenají více položek a častější chybějící blok i v regionální cache. Pak se metadata musí načíst ze vzdálenějšího úložiště místo rychlejšího zdroje v dané oblasti. Vercel při měření našel rovnováhu přibližně u 200 kB na blok: regionální cache dál nacházela správná data často, zatímco přenos do procesu byl levnější.
Vercel ještě zkoumal, zda by stejný počet cest dokázal vměstnat do menšího bloku. Podobně začínající cesty by mohly sdílet uložený začátek, opakovaná metadata by se nemusela zapisovat víckrát a šlo by použít úspornější vlastní formát. Offline zkoušky ale předpovídaly jen malé další zrychlení. Zavedení a údržba složitějšího zápisu by se pro tuto změnu nevyplatily.
Co znamená naměřených 91 procent
Ve svém technickém rozboru Vercel porovnává staré a nové uspořádání na požadavcích produkčních webů mezi 5. a 12. srpnem 2026. V 99. percentilu klesl čas dohledání metadat z 215,8 na 19,1 milisekundy, tedy přibližně o 91 %. Tento percentil je hranice, do které se vejde 99 % měřených dob; ukazuje tak i dopad na pomalejší požadavky. Průměr klesl z 8,59 na 1,81 milisekundy, přibližně o 79 %. Obě čísla popisují hledání metadat, jednu část směrování, ne dobu načtení celé stránky.
U vlastních dokumentačních a marketingových webů Vercelu zůstal medián dohledání metadat kolem 0,7 milisekundy. Jejich 99. percentil přitom klesl z 203 na 31 milisekund. Běžné dohledání už bylo rychlé; změna pomohla hlavně požadavkům, které dříve čekaly na chybějící metadata. Tato dvě čísla platí pro zmíněné weby Vercelu, zatímco srovnání 215,8 a 19,1 milisekundy pochází z širšího souboru požadavků.
U velkých webů se podle Vercelu přibližně dvakrát zrychlil také 99. percentil celé fáze vyřešení cesty. Po ní však může následovat spuštění funkce, získání dat nebo přenos obsahu k uživateli. Proto ani tento výsledek neznamená dvojnásobně rychlejší načtení stránky. Nejvíce se projeví tam, kde vyhledání metadat tvořilo podstatnou část čekání.
Stejná odpověď i po změně úložiště
Při změně uložení metadat hrozilo, že CDN vybere jiný výstup nebo vrátí nesprávný stavový kód, třeba 404 u existující stránky. Vercel proto na testovacích nasazeních porovnal výsledky obou postupů pro všechny cesty. V produkci pak u náhodného vzorku požadavků spočítal oba výsledky, ale uživateli stále posílal odpověď určenou starým postupem. Tento stínový režim běžel několik týdnů a umožnil hledat rozdíly bez dopadu nového formátu na odpovědi.
Jedna z mála odchylek přitom odhalila chybu ve starém formátu. Cesty se znaky mimo ASCII ukládal v krátkých zakódovaných úsecích podle RFC 2047. Když se emoji rozdělilo mezi dva úseky, při čtení se původní cesta nesložila správně. Nový formát ukládá cesty přímo v UTF-8, bez takového dělení, takže se tato konkrétní chyba v něm neobjeví. Porovnání obou postupů tak našlo problém, který samotné měření rychlosti neukáže.
Změna zkrátila i přípravu nasazení. Vercel už nemusí nahrávat metadata po jednotlivých cestách, zapisovat údaje o skupinách tras do manifestu, tedy souhrnného souboru nasazení, ani nahrávat soubory, které po těchto úpravách zůstaly prázdné. Podle Vercelu to ušetřilo dohromady 16,6 sekundy. Samotný krok nasazování se zrychlil zhruba o desetinu napříč projekty; u projektů s velkým množstvím metadat firma odhaduje zlepšení kolem čtvrtiny.
Pro vývojáře se nemění Build Output API, rozhraní, kterým se Vercelu předávají výsledky sestavení webu. Změnil se způsob, jakým z nich Vercel ukládá a dohledává směrovací metadata. Nový formát se používá u nasazení vytvořených po 17. červenci 2026; u staršího nasazení je pro tuto změnu třeba projekt znovu nasadit.
První načtení bloku po nasazení nové verze připraví metadata i pro další cesty. Pokud má proces blok v lokální cache, nemusí jej přenášet vůbec. Když jej najde až v regionální cache, putuje k němu zhruba 200 kB, zatímco u původně zkoušených bloků to bylo několik megabajtů. Zrychlení tedy nezáviselo jen na tom, kolik cest se načte najednou. Stejně důležité bylo, jak dlouho potrvá přenos bloku k procesu, který právě vyřizuje požadavek.

Ondřej Dolejš
Nadšenec do techniky v celé její šíři. Od nejnovějších smartphonů přes operační systémy až po kód, který za tím vším stojí. Věří, že nejzajímavější věci se dějí tam, kde se hardware potkává se softwarem.